Am 12. November war ich beim IT Kongress Neu-Ulm | Ulm an der Hochschule Neu-Ulm. Einen der Vorträge habe ich mir im Security Track in Hörsaal C angehört: „Angriff der Maschinen: Wie KI Pentesting die Angriffsvektoren verändert“ von Vinzenz Felder, Senior Cybersecurity Consultant bei SMTnet Data Communications.
Das Thema beschäftigt mich auch in unserer eigenen Entwicklung. Wir erleben Angriffe auf Unternehmen und Infrastrukturen. Gleichzeitig bleiben vielerorts Anwendungen im Einsatz, deren Wartung überfällig ist. Updates werden verschoben, alte Komponenten weiterverwendet und Berechtigungen einmal eingerichtet, ohne sie später ausreichend zu hinterfragen. Aus meiner Sicht wird Sicherheit noch zu häufig erst dann ernst genommen, wenn bereits etwas passiert ist.
Aus dem Vortrag nehme ich deshalb eine Frage mit, die unsere eigene Arbeit betrifft: Wie können wir KI einsetzen, um Schwachstellen in unserer Software selbst zu finden, bevor jemand anderes sie ausnutzt? Die folgenden Überlegungen beschreiben unseren Ansatz bei OAKMIND und meine Schlussfolgerungen, keine Zusammenfassung aller Aussagen des Referenten.
Angreifer suchen nach einem Weg
Eine Anwendung muss nicht an einer einzigen spektakulären Sicherheitslücke scheitern. Manchmal entsteht ein Angriffsweg aus mehreren kleineren Schwächen: Eine Schnittstelle gibt zu viel preis, eine Berechtigung ist zu großzügig und eine weitere Funktion vertraut einer Eingabe, die sie hätte prüfen müssen.
KI kann helfen, solche Möglichkeiten zu untersuchen und unterschiedliche Ansätze durchzuspielen. Zusammen mit dem Wissen und den Werkzeugen eines erfahrenen Angreifers ist das ein Risiko, das wir als Entwickler ernst nehmen müssen. Nur den vorgesehenen Ablauf einer Anwendung zu testen, reicht dafür nicht. Wir müssen auch prüfen, was passiert, wenn jemand bewusst anders vorgeht.
Wenn eine Webseite dem Agenten Anweisungen gibt
Bei KI Anwendungen kommt eine zusätzliche Angriffsfläche hinzu. Ein Agent liest eine Webseite, wertet eine Datei aus oder recherchiert über eine Websuche. In den gefundenen Inhalten können Anweisungen stehen, die sein Verhalten verändern sollen. Das wird als Prompt Injection bezeichnet. Bei einer indirekten Prompt Injection gelangen diese Anweisungen beispielsweise über eine fremde Webseite oder ein Dokument in den Kontext des Modells.
Du beauftragst einen Assistenten, Informationen zu recherchieren. Eine der gelesenen Seiten versucht jedoch, ihn zu einer anderen Handlung zu bewegen. Der Agent sollte diese Passage als fremden Inhalt behandeln. Übernimmt er sie stattdessen als Auftrag, kann er vom eigentlichen Nutzerwunsch abweichen. Dafür musst du die manipulierte Passage nicht selbst gesehen haben. Auch eine eingehende E-Mail oder ein Dokument in einer Wissenssammlung kann ein solcher Einstiegspunkt sein. OWASP beschreibt diese direkten und indirekten Angriffe auf KI Anwendungen.
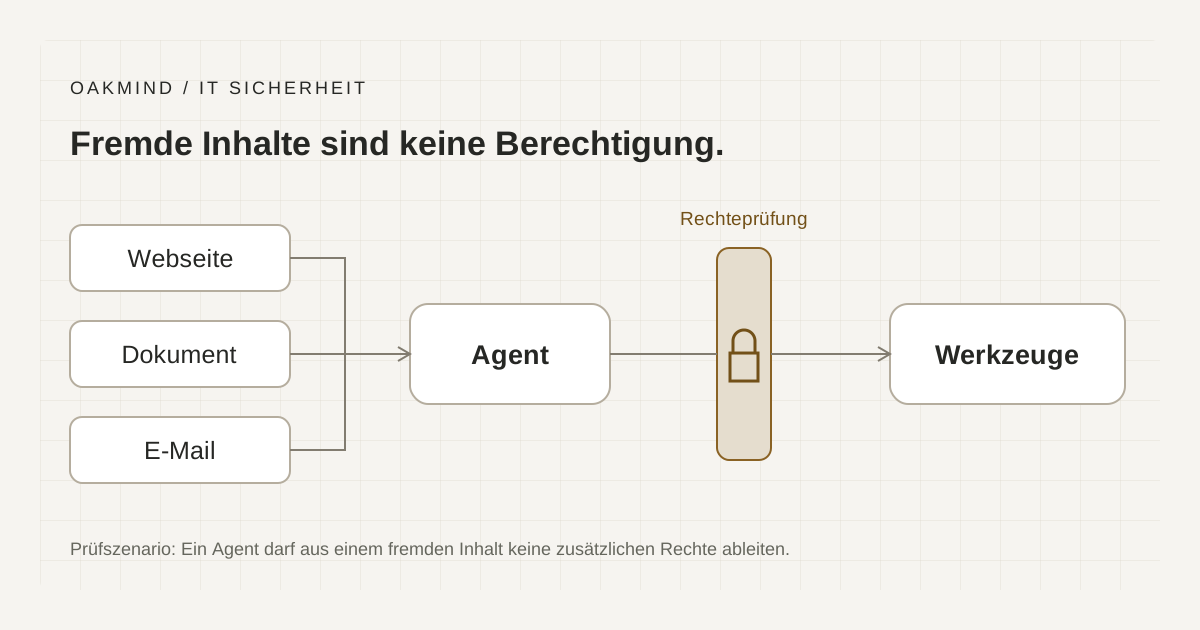
Die Grafik oben zeigt diesen Zusammenhang vereinfacht: Fremde Inhalte erreichen den Agenten. Seine anschließenden Werkzeugzugriffe müssen trotzdem eine separate Berechtigungsprüfung bestehen. Das ist ein Prüfszenario, kein Nachweis eines konkreten Sicherheitsvorfalls.
Unbedachte Freigaben und Agenten mit zu viel Zugriff
Auch Nutzer können Fehler machen. Eine Freigabe wird schnell bestätigt, ein vertrauliches Dokument versehentlich hochgeladen oder einem Assistenten mehr Zugriff eingeräumt, als er für die Aufgabe braucht. Eine sichere Anwendung muss damit rechnen. Sie darf nicht voraussetzen, dass jeder Nutzer sämtliche technischen Folgen einer Entscheidung überblickt.
Besonders kritisch wird es, wenn ein Agent selbst handeln kann. Ein Assistent, der E-Mails zusammenfassen soll, benötigt nicht automatisch die Möglichkeit, Nachrichten zu versenden oder zu löschen. Ein Werkzeug zum Lesen von Dokumenten braucht nicht nebenbei Zugriff auf alle Dateien aller Nutzer.
Ein Modell kann Vorgaben falsch interpretieren oder durch manipulierte Inhalte von ihnen abgebracht werden. Seine Guardrails sind deshalb keine verlässliche Zugriffssperre. Welche Folgen ein solcher Fehler hat, hängt wesentlich von den Werkzeugen, Rechten und Freigaben rund um den Agenten ab. OWASP fasst das Risiko übermäßiger Handlungsmöglichkeiten unter „Excessive Agency“ zusammen.
Für mich folgt daraus: Berechtigungen müssen unabhängig vom Modell technisch geprüft werden. Eine Anweisung im Systemprompt ersetzt keine serverseitige Zugriffskontrolle. Ein Agent darf durch den Inhalt einer Webseite keine zusätzlichen Rechte bekommen. Folgenreiche Aktionen brauchen eine nachvollziehbare Freigabe.
Wenn Guardrails den eigenen Sicherheitstest abbrechen
Bei unseren eigenen Prüfungen erleben wir eine andere Seite der Schutzmechanismen. Führende Cloudmodelle verweigern teilweise aktive Angriffsversuche, obwohl sich der Test ausdrücklich gegen unsere eigene Software richtet. Die Guardrails beenden dann einen Prüfweg, den wir zur Untersuchung einer möglichen Schwachstelle weiterverfolgen müssten.
Für allgemeine Assistenten sind solche Schutzmechanismen nachvollziehbar. In einem autorisierten Sicherheitstest brauchen wir jedoch die Möglichkeit, einen Verdacht innerhalb einer freigegebenen Testumgebung tatsächlich zu überprüfen. Eine Erklärung, wie eine Schwachstelle grundsätzlich funktioniert, beantwortet noch nicht, ob unsere Anwendung an dieser Stelle angreifbar ist.
Das ist unsere praktische Erfahrung, keine pauschale Aussage über jedes Modell oder jeden Anbieter. Auch lokale Modelle unterscheiden sich in ihrem Verhalten. Entscheidend ist, ob das gewählte Modell zusammen mit den passenden Werkzeugen den erlaubten Test durchführen kann.
Warum wir dafür große lokale Modelle einsetzen
Bei OAKMIND setzen wir für diese Arbeit auf große, lokal betriebene Modelle statt ausschließlich auf Cloudmodelle von OpenAI oder Anthropic. Wir wählen Modelle aus, mit denen wir die autorisierten Angriffswege auf unsere eigenen Systeme weiter untersuchen können.
Der lokale Betrieb gibt uns Kontrolle darüber, welche Informationen das Modell erhält und welche Werkzeuge es benutzen darf. Sensibler Quellcode und interne Systeminformationen können dabei in unserer eigenen Umgebung bleiben. Das ist gerade bei einer Sicherheitsprüfung relevant, weil wir der prüfenden KI Einblicke geben, die wir nicht öffentlich machen möchten.
Die Freiheit des prüfenden Modells gehört dabei in eine klar begrenzte Umgebung. Sie bedeutet nicht, dass ein produktiver Assistent ohne technische Grenzen auf Daten und Infrastruktur zugreifen sollte. Unser Prüfwerkzeug und die Anwendung, deren Sicherheit wir untersuchen, erfüllen unterschiedliche Aufgaben.
Unsere eigene Angriffssuite
Für diese Arbeit haben wir bei OAKMIND eine eigene Angriffssuite. Sie versucht mit KI gestützten Angriffstests, unsere eigene Software zu überwinden und mögliche Schwachstellen aufzudecken.
Für eine solche Prüfung sind konkrete Fragen wichtig: Kann ein normales Nutzerkonto auf fremde Daten zugreifen? Lässt sich eine vorgesehene Grenze durch eine ungewöhnliche Abfolge von Aktionen umgehen? Was geschieht, wenn ein Agent einen manipulierten Inhalt liest oder eine Handlung außerhalb seines Auftrags vorschlägt?
Ein Hinweis des Modells ist noch kein bestätigter Befund. Ein brauchbares Ergebnis muss nachvollziehbar sein: Unter welchen Bedingungen tritt der Fehler auf, was lässt sich tatsächlich erreichen und verhindert die anschließende Korrektur genau diesen Weg? Dazu gehört auch die erneute Prüfung nach der Behebung. Eine geänderte Codezeile allein beweist noch nicht, dass das Problem gelöst ist.
Mein Fazit
Jedes Unternehmen und jede Kommune sollte die eigene Software mit geeigneten Mitteln selbst angreifen und prüfen, ob sie auch KI gestützten Angriffsversuchen standhält. Wer Anwendungen betreibt oder KI Agenten Zugriff auf Daten und Werkzeuge gibt, sollte wissen, wo deren Grenzen tatsächlich liegen und ob diese Grenzen einer gezielten Prüfung standhalten.
Dafür braucht es autorisierte Tests auf den eigenen oder ausdrücklich freigegebenen Systemen, einen klar begrenzten Prüfumfang und die passenden Werkzeuge. Lokale KI kann dabei helfen, mögliche Angriffswege zu untersuchen. Fachkundige Begleitung und unabhängige Pentests bleiben wichtig, denn auch ein großes Modell findet nicht alle Schwachstellen.
Für mich gehört diese Prüfung zu einem verantwortungsvollen Umgang mit Software. Gefundene Lücken müssen nachvollziehbar geschlossen und die Korrekturen erneut getestet werden. So entsteht eine belastbarere Grundlage für Sicherheit als durch das Vertrauen darauf, dass die Anwendung im Alltag bisher funktioniert hat. Diesen Anspruch nehme ich aus Neu-Ulm mit in unsere tägliche Entwicklung bei OAKMIND.